
هوش مصنوعی و اینترنت اشیا محصول کهن سیستم
سرور هوش مصنوعی شرکتها | صرفهجویی، سرعت و امنیت در یک سیستم
تمرکز، امنیت و بهرهوری: راهکار هوشمند شرکتهای کوچک و متوسط
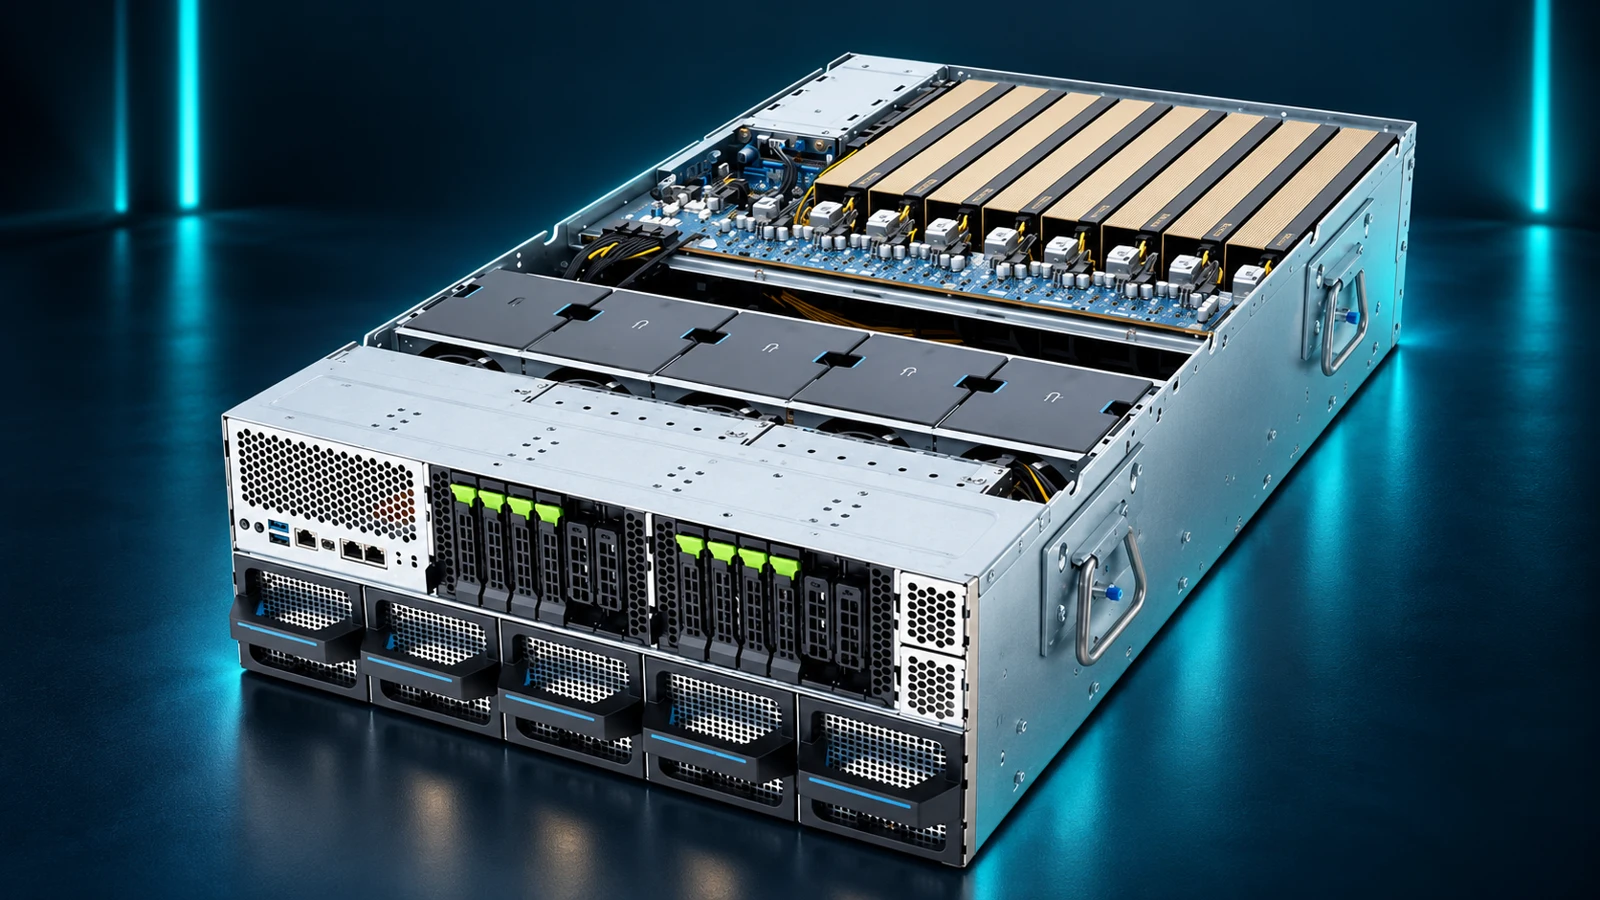
سرورهای کهن سیستم فردا یک راهکار هوشمند، مقرونبهصرفه و کاربردی برای شرکتها و کسبوکارهای کوچک هستند که میخواهند بدون صرف هزینههای سنگین، سرعت کار تیم خود را افزایش دهند و امور روزمره را سادهتر کنند.
با استفاده از این سرور، تمام پردازشها، تحلیل اطلاعات و مدیریت دادهها بهصورت متمرکز و سریع انجام میشود، بدون اینکه نیاز به خرید چندین سیستم گرانقیمت یا وابستگی به اینترنت داشته باشید. این راهکار باعث کاهش هزینهها، افزایش امنیت اطلاعات و بالا رفتن بهرهوری کارکنان میشود.
- تجربه در خدمات شبکه
- ۱۹ سال
- دفتر
- ۰۲۱-۲۶۲۳۰۰۵۴
چرا این محصول
کاهش هزینههای شرکت
صرفهجویی هوشمند با سرور هوش مصنوعی
بهجای خرید چندین کامپیوتر قدرتمند برای هر کارمند و صرف هزینههای سنگین، میتوانید تنها با یک سرور مرکزی تمام نیازهای پردازشی شرکت را پوشش دهید. این سرور امکان اجرای همزمان وظایف کارکنان را فراهم میکند و هزینه خرید تجهیزات، تعمیرات و مصرف برق را به شکل چشمگیری کاهش میدهد. به همین دلیل، این راهکار برای شرکتهای کوچک و متوسط یک گزینه اقتصادی، هوشمندانه و منطقی است که بهرهوری و سرعت انجام کارها را نیز افزایش میدهد.
همکاری همزمان هوشمند
استفاده همزمان چند کارمند با یک سیستم مرکزی
تمام اعضای تیم قادر خواهند بود بهصورت همزمان و بدون محدودیت از امکانات سیستم مرکزی استفاده کنند، بدون اینکه هر یک نیازمند تهیه و نگهداری سیستمهای گرانقیمت و مجزا باشند. این رویکرد باعث میشود که فرآیندهای کاری سریعتر پیش بروند، زمان انتظار و معطلی کارکنان به حداقل برسد و همکاری بین اعضای تیم به شکل مؤثرتری انجام شود. در نتیجه، بهرهوری کلی مجموعه بهطور چشمگیری افزایش پیدا میکند و تیم میتواند با هماهنگی بهتر و دسترسی آسان به منابع، پروژهها و وظایف روزانه را با کیفیت بالاتر و در زمان کوتاهتری به انجام برساند.

فرایند بدون اینترنت
کارکرد بدون وابستگی به اینترنت
یکی از مزایای کلیدی استفاده از این سرور، امکان بهرهبرداری کاملاً آفلاین از سیستم است. حتی در مواقعی که اینترنت قطع شود یا دسترسی به شبکههای خارجی محدود گردد، فعالیتهای روزمره شرکت بدون هیچگونه وقفه یا اختلال ادامه پیدا میکند. این قابلیت نه تنها باعث حفظ روند کاری و افزایش پایداری عملیات شرکت میشود، بلکه امنیت اطلاعات حساس را نیز تضمین میکند و از خروج دادهها به محیطهای خارجی جلوگیری مینماید. بنابراین، شرکت میتواند با آرامش خیال، کارهای حیاتی خود را بدون وابستگی به اینترنت انجام دهد و اطمینان داشته باشد که دادههای داخلی همواره در محیط امن باقی میمانند.
امنیت داده داخلی
حفظ امنیت و محرمانگی اطلاعات شرکت
تمام اسناد، فایلها و دادههای شرکت بهصورت کاملاً ایمن روی سرور داخلی خودتان ذخیره میشوند و هیچگونه اطلاعاتی به فضای بیرون منتقل نمیشود. این قابلیت باعث میشود که مدیران و کارکنان شرکت بتوانند با آرامش کامل روی فعالیتهای روزمره خود تمرکز کنند، بدون نگرانی از نشت اطلاعات یا دسترسی غیرمجاز به دادهها. حفظ محرمانگی اسناد و امنیت اطلاعات، نه تنها اعتماد داخلی را افزایش میدهد، بلکه اطمینان میبخشد که اطلاعات حساس شرکت همواره تحت کنترل کامل باقی میماند. با این روش، امکان نظارت متمرکز بر دادهها و مدیریت ایمن اطلاعات فراهم میشود و شرکت میتواند بدون هیچ ریسکی، فعالیتهای حیاتی خود را ادامه دهد و از ارزشمندترین دارایی خود یعنی اطلاعات محافظت کند.

امکاناتی که بهرهوری شرکت شما را افزایش میدهد

-

پردازش سریع و روان
انجام پردازشها و تحلیل اطلاعات بدون کندی و معطلی، حتی در حجم کاری بالا.
-

دسترسی همزمان چند کاربر
امکان استفاده چندین نفر بهصورت همزمان بدون افت کیفیت عملکرد.
-

عملکرد کاملاً آفلاین
بدون نیاز به اینترنت و بدون وابستگی به سرویسهای خارجی.
-

امنیت بالای اطلاعات
ذخیرهسازی تمامی دادهها داخل شرکت و جلوگیری از خروج اطلاعات.
-

قابلیت ارتقا در آینده
امکان افزایش توان سیستم متناسب با رشد کسبوکار بدون نیاز به تعویض کامل تجهیزات.
-
نصب، راهاندازی و پشتیبانی کامل
ارائه خدمات نصب، آموزش و پشتیبانی توسط تیم فنی کهن سیستم فردا.
مزایای خرید از کهن سیستم فردا
-
صرفهجویی اقتصادی هوشمندانه
کاهش هزینه خرید تجهیزات متعدد، کاهش هزینه نگهداری و مصرف برق و افزایش عمر مفید سیستمها باعث میشود سرمایهگذاری شما کاملاً منطقی و مقرونبهصرفه باشد.

-
افزایش بهرهوری تیم
با این سرور، کارکنان میتوانند سریعتر و مؤثرتر کار کنند، بدون صرف وقت برای مدیریت چندین سیستم و سختافزار.

-
طراحی متناسب با نیاز و بودجه شما
قبل از اجرا، شرایط کاری شرکت شما بررسی میشود و بهترین راهکار متناسب با بودجه، تعداد کاربران و نوع فعالیت پیشنهاد میگردد.
-
پشتیبانی سریع و حرفهای
در تمام مراحل، از مشاوره تا نصب، راهاندازی و خدمات پس از فروش، تیم فنی کهن سیستم فردا در کنار شما خواهد بود تا هیچ دغدغهای نداشته باشید.
سوالات متداول درباره سرور هوش مصنوعی
پرسشهای متداول
آیا این سرور میتواند جایگزین خرید چند سیستم کامپیوتری شود؟
بله. با استفاده از این سرور، دیگر نیازی به خرید چندین سیستم گرانقیمت نخواهید داشت و تمام پردازشها بهصورت متمرکز انجام میشود.
آیا در صورت قطع اینترنت کار شرکت متوقف میشود؟
خیر. سیستم بهصورت کاملاً آفلاین کار میکند و حتی در زمان قطع اینترنت نیز بدون هیچ مشکلی قابل استفاده است.
اطلاعات شرکت کجا ذخیره میشود؟
تمام اطلاعات فقط روی سرور داخل شرکت شما ذخیره میشود و به هیچ فضای خارجی ارسال نمیگردد.
یا استفاده از این سیستم نیاز به دانش فنی دارد؟
خیر. محیط کاربری ساده طراحی شده تا تمام کارکنان بتوانند بهراحتی از آن استفاده کنند.
چرا کهن سیستم فردا انتخاب مناسبی است؟
به دلیل تجربه تخصصی، طراحی اقتصادی، پشتیبانی حرفهای و ارائه راهکارهای ساده و کاربردی مخصوص کسبوکارهای کوچک.
مقالات مرتبط
-
سرور هوش مصنوعی چیست؟ راهکاری نوین برای مدیریت هوشمند زیرساختهای IT
انتخاب یک سرور هوشمند میتواند نقطه عطفی در توسعه و بهینهسازی زیرساخت فناوری اطلاعات هر سازمان باشد. این راهکار با ترکیب قدرت پردازشی…
-
نگهداری شبکه چیست؟ راهنمای جامع و کامل نگهداری و پشتیبانی شبکههای کامپیوتری
نگهداری شبکه یکی از ارکان اصلی پایداری، امنیت و عملکرد صحیح شبکههای کامپیوتری در سازمانها و کسبوکارهای امروزی است. این مقاله بهصورت…
-
چت بات سازمانی پادیار: تحول هوشمند در تعامل سازمانی با ویدئو چت بات
چت بات سازمانی پادیار با قابلیت پیشرفته ویدئو چت بات و هوش مصنوعی، تجربه تعامل سازمانی را متحول کرده و ارتباطات داخلی و خارجی شرکتها را…

خدمات مرتبط
-
طراحی شبکه
طراحی شبکه با بررسی تعداد کاربران، تجهیزات، ارتباطات و نیازهای رشد سازمان آغاز میشود. مشاوره فنی مسیر انتخاب معماری و…
-
پشتیبان گیری
انتخاب راهکار پشتیبانگیری با شناخت دادهها، بارهای کاری و زمان قابل قبول برای بازیابی شروع میشود. در مشاوره، سیاست…
-
پادیار
چت بات پادیار یک پلتفرم پیشرفته برای مدیریت ارتباطات و فرایندهای درونسازمانی است که توسط شرکت کهن سیستم فردا طراحی و…
-
مشاوره هوش مصنوعی
مسیر استفاده از هوش مصنوعی را با بررسی مسئله، دادههای در دسترس و فرایندهای سازمان شروع کنید. در خدمات مشاوره،…



تکمیلی
بخشهای زیر مکمل متن اصلی صفحهاند و بر پایهٔ منابع رسمی فهرستشده در انتهای همین بخش نوشته شدهاند.
سرور هوش مصنوعی سازمانی چیست؟
سرور هوش مصنوعی سازمانی رایانهٔ مرکزی است که مدلهای هوش مصنوعی، بهویژه مدل زبانی بزرگ (LLM)، را داخل شبکهٔ خود شرکت اجرا میکند تا کارکنان بدون فرستادن اسناد به سرویس بیرونی از آنها استفاده کنند. اجرای مدل روی زیرساخت خود سازمان را on-premise مینامند؛ در مقابل، در سرویس ابری مدل روی زیرساخت ارائهدهنده اجرا میشود.
تفاوت اصلی با سرور معمولی در حافظه و توان محاسبه است: مدلهای زبانی حافظهٔ زیاد و پهنای باند حافظهٔ بالا میخواهند و معمولاً با GPU اجرا میشوند. طبق صفحهٔ کهن سیستم فردا، «سرور هوش مصنوعی» یک سرور مرکزی است که آفلاین کار میکند و داده را داخل شرکت نگه میدارد؛ مدل و سختافزار دقیق در پیشنهاد فنی مشخص میشود. برای شناخت وجه عمومیتر این موضوع مقالهٔ «سرور هوش مصنوعی چیست؟» را هم ببینید.
روش کار و مراحل
صفحهٔ اصلی این محصول میگوید پیش از اجرا، شرایط کاری شرکت بررسی میشود و راهکار بر پایهٔ بودجه، تعداد کاربران و نوع فعالیت پیشنهاد میگردد. برای اینکه این بررسی ملموس باشد، ترتیب زیر را بهعنوان چارچوب پیشنهادی ببینید (جزئیات و زمانبندی هر پروژه در جلسهٔ مشاوره مشخص میشود):
- نیازسنجی: فهرست کاربران همزمان، کارهایی که باید روی سرور انجام شود، حجم و نوع اسناد. خروجی: برگهٔ نیازها.
- بررسی داده: داده کجا ذخیره است، چه کسی به چه بخشی دسترسی دارد و کدام بخش حساس است. خروجی: نقشهٔ داده و سطح دسترسی.
- طراحی و پیشنهاد: انتخاب ظرفیت سختافزار و نرمافزار متناسب با بودجه و رشد آینده. خروجی: سند پیشنهاد فنی.
- نصب و راهاندازی: استقرار در محل شرکت و اتصال به شبکهٔ داخلی. خروجی: سرور آمادهٔ بهرهبرداری.
- آزمون محدود: یک گروه کوچک کاربر چند کار مشخص را اجرا میکند و نتیجه با معیارهای از پیش تعیینشده مقایسه میشود.
- آموزش و پشتیبانی: آموزش کارکنان و پشتیبانی پس از راهاندازی، مطابق آنچه صفحه بهعنوان خدمات نصب، آموزش و پشتیبانی معرفی میکند.
برآورد سرانگشتی حافظه: چه مدلی روی چه سختافزاری جا میشود؟
حافظهٔ لازم برای وزنهای مدل را میتوان با یک ضرب ساده تخمین زد: تعداد پارامترها (به میلیارد) ضرب در تعداد بایت هر پارامتر. هر پارامتر در دقت FP16 حدود ۲ بایت، در INT8 حدود ۱ بایت و در کوانتیزاسیون ۴ بیتی حدود نیم بایت میگیرد (توضیح کوانتیزاسیون در مستندات Hugging Face آمده است). جدول زیر محاسبهٔ حسابی همین ضرب است، نه اندازهگیری روی یک محصول مشخص:
| اندازهٔ مدل | وزنها در FP16 | وزنها در INT8 | وزنها در ۴ بیت |
|---|---|---|---|
| ۸ میلیارد پارامتر | حدود ۱۶ گیگابایت | حدود ۸ گیگابایت | حدود ۴ گیگابایت |
| ۳۲ میلیارد پارامتر | حدود ۶۴ گیگابایت | حدود ۳۲ گیگابایت | حدود ۱۶ گیگابایت |
| ۷۰ میلیارد پارامتر | حدود ۱۴۰ گیگابایت | حدود ۷۰ گیگابایت | حدود ۳۵ گیگابایت |
این اعداد فقط وزنها را شامل میشوند. حافظهٔ نگهداری زمینهٔ گفتگو (KV cache)، تعداد کاربران همزمان، طول سند ورودی و سربار نرمافزار بالاتر از آن اضافه میشود؛ بنابراین ظرفیت واقعی را باید با آزمون روی سند و بار خودتان سنجید. نکتهٔ دیگر: سرعت تولید متن معمولاً به پهنای باند حافظه هم وابسته است، نه فقط به تعداد هستهها؛ برای همین مقایسهٔ دو سرور فقط با «تعداد هسته» یا «مقدار رم» گمراهکننده است.
فناوریها و استانداردهای روز
توجه: صفحهٔ کهن سیستم فردا مشخصات فنی دقیق (نوع GPU، مدل زبانی یا نرمافزار) را ذکر نمیکند. آنچه در این بخش میخوانید راهنمای عمومی صنعت است و مشخصهٔ رسمی این محصول نیست؛ مشخصات واقعی را در پیشنهاد فنی از کهن سیستم فردا بخواهید.
- مدلهای زبانی با مجوز باز: در ۱۲ ماه گذشته چند خانوادهٔ مدل با مجوز Apache 2.0 در Hugging Face منتشر یا بهروز شدهاند؛ از جمله gpt-oss-120b (کارت مدل ۲۰۲۵-۰۸-۰۸، قابل اجرا روی یک GPU با ۸۰ گیگابایت حافظه)، Qwen3.5 (فوریهٔ ۲۰۲۶) و Gemma 4 (گزارش فنی ۲۰۲۶-۰۷-۰۲). کیفیت فارسی هر مدل در صفحات رسمیشان تأیید نشده و باید روی اسناد خودتان آزموده شود.
- موتورهای اجرا: vLLM (سرور سازگار با API مشابه OpenAI)، Ollama و llama.cpp رایجترین گزینههای اجرای محلیاند. انتخاب میان آنها به تعداد کاربر همزمان و سختافزار بستگی دارد.
- جستوجو در اسناد (RAG): برای پاسخ بر پایهٔ اسناد داخلی، متن به قطعهها تقسیم و نمایه میشود و پاسخ فقط از قطعههای مجاز ساخته میشود. کنترل دسترسی باید هنگام جستوجو اعمال شود.
- حافظهٔ GPU: قاعدهٔ سرانگشتی: وزنها در دقت ۱۶ بیتی حدود دو بایت برای هر پارامتر میگیرند، یعنی مدل ۸ میلیارد پارامتری تنها برای وزنها حدود ۱۶ گیگابایت لازم دارد. حافظهٔ گفتگوهای همزمان (KV cache) جداست. فشردهسازی (quantization) نیاز را کم میکند ولی باید روی کیفیت فارسی آزمون شود.
- چارچوبهای ریسک: OWASP Top 10 for LLM Applications (ویرایشی ۲۰۲۵ در صفحهٔ رسمی) ریسکهایی مانند تزریق دستور، افشای اطلاعات حساس و بردارها را فهرست میکند؛ NIST AI RMF چارچوب مدیریت ریسک هوش مصنوعی است.
برای گسترش به عاملهای هوشمند و نمونههای متنباز به هاب هوش مصنوعی عاملمحور سر بزنید.
واژهنامهٔ کوتاه
| اصطلاح | معنا در یک جمله |
|---|---|
| LLM (مدل زبانی بزرگ) | مدلی که از حجم زیادی متن یاد گرفته و متن تولید یا خلاصه میکند. |
| توکن | واحد کوچک متن که مدل میخواند و مینویسد؛ هزینه و سرعت معمولاً بر پایهٔ توکن سنجیده میشود. |
| استنتاج (inference) | اجرای مدل آماده برای پاسخ دادن؛ با آموزش مدل از صفر فرق دارد و منابع کمتری میخواهد. |
| VRAM | حافظهٔ کارت گرافیک که وزنهای مدل در آن بارگذاری میشود. |
| کوانتیزاسیون | کاهش دقت عددی وزنها برای کمکردن حافظه، با احتمال افت کیفیت. |
| RAG | بازیابی اسناد مرتبط و دادن آنها به مدل برای پاسخ مبتنی بر منبع. |
| on-premise | اجرا روی زیرساخت خود سازمان، نه روی ابر ارائهدهنده. |
| vLLM / Ollama / llama.cpp | نرمافزارهایی برای اجرای محلی مدل؛ انتخاب بین آنها به بار کاری و مهارت تیم بستگی دارد. |
مقایسهٔ رویکردها
جدول زیر سه الگوی کلی را مقایسه میکند. این مقایسه عمومی است و ادعای عملکردی دربارهٔ محصول خاصی نیست.
| معیار | سرویس ابری (API خارجی) | سرور داخلی (on-premise) | ترکیبی (hybrid) |
|---|---|---|---|
| محل داده | نزد ارائهدهنده | داخل شرکت | داده حساس داخل، بقیه بیرون |
| وابستگی به اینترنت | کامل | میتواند آفلاین باشد (طبق صفحهٔ محصول) | جزئی |
| ساختار هزینه | مصرفمحور و مستمر | سرمایهای اولیه بهعلاوهٔ برق، نگهداری و پشتیبانی | ترکیب هر دو |
| نگهداری و بهروزرسانی | بر عهدهٔ ارائهدهنده | بر عهدهٔ شرکت یا پشتیبان | تقسیم میان دو طرف |
| مقیاسپذیری | سریع | طبق ظرفیت سختافزار؛ صفحه ارتقا در آینده را ذکر میکند | انعطافپذیر |
| مناسب برای | داده کمحساس، آزمایش سریع | داده محرمانه، شبکهٔ محدود | سازمان با بارهای متنوع |
هزینه و عوامل آن
کهن سیستم فردا در این صفحه قیمت منتشر نمیکند و هزینه پس از نیازسنجی برآورد میشود. آنچه باید در هر پیشنهاد جداگانه دیده شود:
- سختافزار: نوع و تعداد GPU، حافظه، ذخیرهسازی و شبکه.
- نرمافزار و مدل: مجوز مدل یا موتور اجرا (برخی مدلها مجوز باز دارند، برخی نه) و هزینهٔ یکپارچهسازی با اسناد و کاربران.
- زیرساخت محل: برق، خنکسازی، رک و شبکه.
- نیروی انسانی: نصب، پایش، بهروزرسانی و پشتیبانی بعد از تحویل.
- ارتقا: مسیر افزودن GPU یا حافظه بدون تعویض کامل سرور.
در مقایسهٔ پیشنهادها، عددی را که فقط قیمت دستگاه است با عددی که نصب، آموزش و پشتیبانی را هم دربر میگیرد مقایسه نکنید.
معیارهای انتخاب و سؤالهایی که باید بپرسید
پیش از خرید هر سرور هوش مصنوعی از فروشنده، از جمله کهن سیستم فردا، این سؤالها را مکتوب بپرسید:
- چند کاربر همزمان و برای چه کاری؟ ظرفیت بر اساس کدام آزمون سنجیده شده است؟
- دقیقاً چه نرمافزار و مدلی روی سرور اجرا میشود و مجوز آن چیست؟
- کیفیت پاسخ فارسی روی اسناد واقعی ما چگونه ارزیابی میشود؟
- دسترسی کاربران به اسناد چگونه کنترل و ثبت میشود؟
- پشتیبانگیری، بهروزرسانی مدل و جایگزینی قطعات چگونه است؟
- ارتقای ظرفیت در آینده شامل چه مواردی است؟
- اجزای هزینهٔ کل مالکیت کداماند: سختافزار، برق و خنکسازی، نیروی نگهداری، آموزش و پشتیبانی؟
- اگر این سرور برای ما لازم نباشد، چه جایگزینی پیشنهاد میشود؟ فروشندهٔ خوب «نه» هم میگوید.
آمادگی محل نصب: چیزهایی که کمتر در فهرست قیمت میآید
فروشندگان سختافزار معمولاً بر کارت گرافیک و رم تمرکز میکنند، اما پروژههای داخلی اغلب روی زیرساخت اطراف گیر میکنند. پیش از سفارش این موارد را مکتوب روشن کنید:
- برق: مصرف کل سرور در بار کامل، ظرفیت UPS و مدار اختصاصی.
- خنکسازی: توان گرمایی سرور و ظرفیت سرمایشی اتاق یا رک؛ این عدد را از تأمینکننده بخواهید.
- فضا و رک: ارتفاع، وزن و نوع ریل سرور.
- شبکه: پهنای باند میان کاربران و سرور و تفکیک شبکهٔ مدیریت از شبکهٔ کاربران.
- دسترسی فیزیکی و لاگ: چه کسی به اتاق سرور و کنسول مدیریت دسترسی دارد.
- پشتیبانگیری: نسخهٔ مدلها، تنظیمات و فهرست اسناد، جدا از خود سرور.
- گارانتی و قطعات: برای سختافزار نو یا استوک، مدت گارانتی و زمان تأمین قطعه را مکتوب بخواهید.
پیادهسازی و پشتیبانی توسط کهن سیستم فردا
طبق صفحهٔ محصول، تیم فنی کهن سیستم فردا مشاوره، نصب، راهاندازی، آموزش و پشتیبانی را انجام میدهد و طرح بر پایهٔ تعداد کاربران، نوع فعالیت و بودجهٔ شما پیشنهاد میشود. این صفحه قیمت یا مشخصات ثابت اعلام نمیکند؛ برای برآورد باید نیازسنجی انجام شود.
اگر هدف شما چتبات سازمانی روی زیرساخت خودتان است، محصول مرتبط چت بات پادیار را ببینید و منبع رسمی آن، padyar.com، را بخوانید. برای تصمیم دربارهٔ اینکه اصلاً هوش مصنوعی چه کاری برای شما انجام دهد، مشاورهٔ هوش مصنوعی نقطهٔ شروع بهتری است.
سناریوی نمونه: پرسشوپاسخ روی اسناد داخلی برای یک شرکت ۵۰ نفره
سناریوی نمونه (فرضی؛ پروژهٔ یک مشتری واقعی نیست). شرکتی ۵۰ نفره میخواهد کارکنان دستورالعملها، قراردادها و راهنماهای فنی داخلی را با پرسش به زبان فارسی جستوجو کنند، بدون اینکه سند از شبکه خارج شود.
- فهرست اسناد و سطح محرمانگی هر گروه مشخص میشود و حداکثر کاربران همزمان برآورد میشود (مثلاً ده نفر).
- ابتدا یک مدل کوچک یا فشرده با بازیابی از اسناد (RAG) روی سختافزار آزمایشی راهاندازی میشود.
- مجموعهای از پرسشهای واقعی با پاسخ مرجع ساخته میشود و کیفیت فارسی، ارجاع به منبع و سرعت پاسخ سنجیده میشود.
- اگر کیفیت یا سرعت کافی نبود، مدل بزرگتر یا GPU قویتر در پیشنهاد فنی بررسی میشود؛ نه برعکس.
- پس از پذیرش، سیاست دسترسی، پشتیبانگیری و برنامهٔ بهروزرسانی آفلاین مکتوب میشود.
هدف این سناریو نشان دادن ترتیب تصمیم است: اول نیاز و آزمون، بعد سختافزار. برای مرحلهٔ RAG طراحی عامل بازیابی دانش را ببینید.
پرسشهای متداول
سرور هوش مصنوعی دقیقاً چه چیزی اجرا میکند؟
صفحهٔ محصول فقط میگوید سرور مرکزی است، آفلاین کار میکند و داده را داخل شرکت نگه میدارد. نرمافزار و مدل مشخصی ذکر نشده؛ آن را در پیشنهاد فنی بپرسید.
آیا برای اجرای مدل زبانی محلی حتماً GPU لازم است؟
برای کاربران همزمان و مدلهای بزرگ معمولاً بله. مدلهای کوچک یا فشرده روی CPU یا GPU کوچک هم اجرا میشوند، ولی سرعت و کیفیت باید آزموده شود.
آفلاین بودن یعنی هرگز بهروزرسانی نمیشود؟
نه؛ میتوان مدل و وصلهها را در بازههای برنامهریزیشده از مسیر کنترلشده منتقل کرد. روش به سیاست امنیتی شما بستگی دارد.
چه چیزی بر قیمت نهایی اثر میگذارد؟
تعداد کاربران، اندازهٔ مدل، حجم اسناد، الزامات امنیتی، سختافزار و سطح پشتیبانی. کهن سیستم فردا پس از نیازسنجی برآورد میدهد و این صفحه عدد منتشر نمیکند.
تفاوت سرور هوش مصنوعی با چتبات پادیار چیست؟
سرور هوش مصنوعی زیرساخت مرکزی داخلی است؛ پادیار طبق padyar.com پلتفرمی با پایگاه دانش، RAG، گردشکار و کانالهای ارتباطی است. میتوانند مکمل هم باشند، اما این ترکیب باید در طرح فنی تأیید شود.
اگر اینترنت قطع شود چه میشود؟
صفحهٔ محصول میگوید کار روزمره ادامه مییابد. سرویسهایی که ذاتاً به اینترنت نیاز دارند، مثل ایمیل بیرونی، البته خارج از این وعدهاند.
کارکنان نیاز به دانش فنی دارند؟
طبق صفحه، محیط کاربری ساده است. با این حال آموزش کوتاه و راهنمای استفاده توصیه میشود.
سرور هوش مصنوعی با سرور معمولی چه فرقی دارد؟
سرور معمولی برای پایگاه داده، فایل یا وب ساخته میشود؛ سرور هوش مصنوعی برای نگهداری وزنهای مدل در حافظه و محاسبهٔ موازی تجهیز میشود، معمولاً با GPU و حافظهٔ پرسرعت.
آیا اجرای مدل زبانی روی CPU ممکن است؟
بله، برای مدلهای کوچک یا فشرده و بار سبک؛ سرعت پاسخ و تعداد کاربران همزمان محدودتر از GPU است. برای پایلوت میتواند آغاز مناسبی باشد، به شرط آنکه معیار پذیرش سرعت را از قبل بنویسید.
برای چند کاربر همزمان چه ظرفیتی لازم است؟
عدد ثابتی وجود ندارد؛ به اندازهٔ مدل، طول متن هر درخواست و زمان پاسخ قابلقبول بستگی دارد. با آزمون بار روی اسناد خودتان تعیین میشود.
کدام مدل زبانی برای فارسی بهتر است؟
کیفیت فارسی هر مدل را باید روی اسناد و پرسشهای خودتان آزمود. صفحههای رسمی مدلها معمولاً نتیجهٔ مستقل برای فارسی سازمانی ارائه نمیکنند.
میتوان سرور داخلی و سرویس ابری را با هم داشت؟
بله؛ الگوی ترکیبی دادههای حساس را داخل نگه میدارد و کارهای کمحساس را به سرویس بیرونی میسپارد. دسترسی به برخی سرویسهای خارجی از ایران محدود است و باید جداگانه بررسی شود.
آیا سرور استوک یا دستدوم گزینهٔ مناسبی است؟
میتواند برای شروع کمهزینهتر باشد، اما گارانتی، سن قطعات، مصرف برق و تأمین قطعهٔ یدکی را مکتوب بررسی کنید.
چطور از اجرای مدل روی سرور به یک عامل (Agent) برسیم؟
سرور زیرساخت اجرای مدل است؛ عامل لایهای است که با ابزارها و سامانهها کار میکند. برای این مسیر هاب هوش مصنوعی عاملمحور و راهاندازی عامل روی زیرساخت اختصاصی را ببینید.
منابع
آخرین بررسی منابع: ۲۹ مهر ۱۴۰۵
- KSF: صفحهٔ سرور هوش مصنوعی شرکتها
- Padyar: صفحهٔ اصلی
- Hugging Face: کارت مدل gpt-oss-120b (Apache 2.0)
- Hugging Face: Qwen3.5-27B
- Hugging Face: Gemma 4 31B
- vLLM (GitHub)
- OWASP Top 10 for LLM Applications
- NIST: AI Risk Management Framework
- Hugging Face: مستندات کوانتیزاسیون (Transformers)
- llama.cpp (GitHub)
- Ollama
نسخهها، مدلها و شرایط لایسنس را سازندهٔ محصول تغییر میدهد؛ پیش از خرید، مقادیر مهم را با کارشناسان کهن سیستم فردا و سند رسمی سازنده تطبیق دهید.